
You are using an out of date browser. It may not display this or other websites correctly.
You should upgrade or use an alternative browser.
You should upgrade or use an alternative browser.
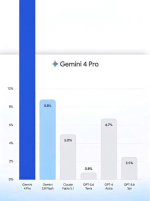
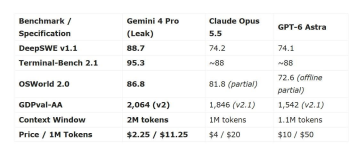
New Gemini 4 Pro benchmark just dropped! number too big to render
- Thread starter cudem_HCM
- Start date
-
- Tags
- gemini 4 pro
google is back?
Điều này cho thấy Gemini 4 Argon có lợi thế rõ khi xử lý các nhiệm vụ dạng:
phân tích tài liệu, tài chính, luật, workflow doanh nghiệp và automation nhiều bước.
Gemini 4 Argon dẫn ở:
49,3%
cao hơn Gemini 4 Argon 45,3% và GPT-6 Astra 44,3%.
Đây là một điểm đáng chú ý nếu công việc liên quan nhiều tới:
Terminal-Bench Science: 68,1%
Nhưng Gemini 4 Argon dẫn rất rõ ở:
Ở GraphWalks:
Điều này cho thấy Gemini 4 Argon có lợi thế lớn khi phải xử lý:
codebase rất lớn, tài liệu dài, repository nhiều file, lịch sử hội thoại dài hoặc agent phải nhớ nhiều ngữ cảnh.
39,5%
Nhưng ở OSWorld-2.0, GPT-6 Astra dẫn:
72,6%
so với Gemini 69,2%.
Nói cách khác, trong các tác vụ điều khiển máy tính và thao tác GUI, GPT-6 Astra đang rất mạnh, còn Gemini vẫn cạnh tranh khá sát.
text + image + chart + tài liệu trực quan.
Nếu workflow cần đọc biểu đồ, screenshot, hình ảnh hay tài liệu đa phương thức, Gemini đang có lợi thế khá rõ.
Điều đó cho thấy ở security/code vulnerability, không có model nào vượt trội hoàn toàn.
Gemini 4 Argon là model có hiệu năng toàn diện và cân bằng nhất, đặc biệt mạnh ở knowledge work, vibe coding, long context, multimodal, science và math.
GPT-6 Astra nổi bật ở một số bài software engineering, science agent và computer use.
Claude Opus 5.5 vẫn rất mạnh ở terminal-based coding agent và ML engineering, tức những tác vụ cần agent làm việc thực tế qua command line.
Điểm đáng chú ý nhất là: không còn một model duy nhất “tốt nhất cho mọi thứ”. Xu hướng ngày càng rõ là mỗi model sẽ có thế mạnh riêng, và workflow hiệu quả nhất có thể là dùng nhiều model cho những phần việc khác nhau.
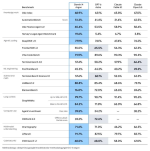
Phân tích nhanh bảng benchmark: Gemini 4 Argon, GPT-6 Astra và Claude 5.x
Nhìn tổng thể, Gemini 4 Argon đang dẫn đầu khá rõ về độ cân bằng, đặc biệt ở các nhóm knowledge work, long context, multimodal và nhiều bài toán agentic coding. Tuy nhiên, GPT-6 Astra và Claude Opus 5.5 vẫn có những mảng thắng riêng, nên chưa thể nói một model vượt trội tuyệt đối trong mọi tình huống.1. Knowledge work: Gemini 4 Argon nổi bật nhất
Ở nhóm công việc tri thức, Gemini 4 Argon đứng đầu cả 4 benchmark:- Vals Index: 68,9%
- AutomationBench: 51,3%
- Vals Finance Agent v2: 65,4%
- Legal Agent Benchmark: 19,6%
Điều này cho thấy Gemini 4 Argon có lợi thế rõ khi xử lý các nhiệm vụ dạng:
phân tích tài liệu, tài chính, luật, workflow doanh nghiệp và automation nhiều bước.
2. Agentic Coding: không có model nào thống trị hoàn toàn
Ở coding, kết quả khá thú vị.Gemini 4 Argon dẫn ở:
- DeepSWE v1.1: 77,9%
- Vibe Code Bench: 91,9%
- FrontierSWE v2: 65,5%
- Terminal-bench 4.0: 66,4%
Mà phải hỏi:“Model nào code giỏi nhất?”
Gemini mạnh về vibe coding và software engineering tổng thể, GPT-6 Astra thể hiện tốt ở một số bài sửa lỗi/codebase khó, còn Claude Opus 5.5 rất mạnh ở môi trường terminal và agent thực thi công việc.“Model nào phù hợp nhất với loại coding nào?”
3. ML Engineering: Claude Opus 5.5 dẫn đầu
Ở PostTrainBench, Claude Opus 5.5 đạt:49,3%
cao hơn Gemini 4 Argon 45,3% và GPT-6 Astra 44,3%.
Đây là một điểm đáng chú ý nếu công việc liên quan nhiều tới:
- training
- post-training
- ML engineering
- tối ưu model
- workflow machine learning
4. Science & Math: Gemini và GPT-6 chia nhau lợi thế
GPT-6 Astra dẫn ở:Terminal-Bench Science: 68,1%
Nhưng Gemini 4 Argon dẫn rất rõ ở:
- LABBench: 88,8%
- RiemannBench: 76,0%
5. Long Context: Gemini 4 Argon thắng rất rõ
Đây có lẽ là một trong những điểm ấn tượng nhất.Ở GraphWalks:
- 128K context: Gemini đạt 99,7%
- 256K–1M context: Gemini đạt 84,2%
Điều này cho thấy Gemini 4 Argon có lợi thế lớn khi phải xử lý:
codebase rất lớn, tài liệu dài, repository nhiều file, lịch sử hội thoại dài hoặc agent phải nhớ nhiều ngữ cảnh.
6. Computer Use: GPT-6 Astra và Gemini cạnh tranh sát nhau
Ở Agent's Last Exam, Gemini dẫn:39,5%
Nhưng ở OSWorld-2.0, GPT-6 Astra dẫn:
72,6%
so với Gemini 69,2%.
Nói cách khác, trong các tác vụ điều khiển máy tính và thao tác GUI, GPT-6 Astra đang rất mạnh, còn Gemini vẫn cạnh tranh khá sát.
7. Multimodal: Gemini tiếp tục dẫn
Gemini 4 Argon đứng đầu cả:- Chartography: 71,6%
- LVBench: 91,7%
text + image + chart + tài liệu trực quan.
Nếu workflow cần đọc biểu đồ, screenshot, hình ảnh hay tài liệu đa phương thức, Gemini đang có lợi thế khá rõ.
8. Cybersecurity: Gemini và GPT-6 ngang nhau
Ở CWE-bench v1:- Gemini 4 Argon: 68,0%
- GPT-6 Astra: 68,0%
- Claude Opus 5.5: 67,0%
- Claude Fable 5.1: 58,0%
Điều đó cho thấy ở security/code vulnerability, không có model nào vượt trội hoàn toàn.
Kết luận nhanh
Nếu chỉ nhìn bảng benchmark này:Gemini 4 Argon là model có hiệu năng toàn diện và cân bằng nhất, đặc biệt mạnh ở knowledge work, vibe coding, long context, multimodal, science và math.
GPT-6 Astra nổi bật ở một số bài software engineering, science agent và computer use.
Claude Opus 5.5 vẫn rất mạnh ở terminal-based coding agent và ML engineering, tức những tác vụ cần agent làm việc thực tế qua command line.
Điểm đáng chú ý nhất là: không còn một model duy nhất “tốt nhất cho mọi thứ”. Xu hướng ngày càng rõ là mỗi model sẽ có thế mạnh riêng, và workflow hiệu quả nhất có thể là dùng nhiều model cho những phần việc khác nhau.