Vibe Coding không chỉ là viết code: Vì sao dự án làm với AI cần SOP, tài liệu đặc tả và hệ thống theo dõi lỗi?
Một trong những ảo tưởng dễ gặp nhất khi bắt đầu làm phần mềm với AI là:Đúng, AI có thể viết code nhanh.“AI viết code rất nhanh, vậy chắc làm sản phẩm cũng sẽ nhanh.”
Nhưng viết code nhanh không đồng nghĩa với xây dựng một hệ thống tốt.
Khi một dự án từ vài nghìn dòng code phát triển thành vài chục nghìn, vài trăm nghìn dòng; khi frontend, backend, database, Redis, WebSocket, cron job, queue, API bên thứ ba và mobile app bắt đầu liên kết với nhau, vấn đề lớn nhất không còn là:
“AI có viết được đoạn code này không?”
Mà trở thành:
“AI có hiểu đúng hệ thống của chúng ta không?”
Và quan trọng hơn:
“Khi hệ thống hỏng, chúng ta có biết chuyện gì vừa xảy ra không?”
Đây là lúc SOP, PRD/SRS/SPD, logging, error tracking, observability và incident management trở nên cực kỳ quan trọng.
1. AI càng viết code nhanh, tài liệu hệ thống càng quan trọng
Trong cách lập trình truyền thống, một developer có thể làm việc với một codebase nhiều tháng hoặc nhiều năm.Họ dần hình thành một thứ gọi là mental model – mô hình hệ thống nằm trong đầu:
- module nào làm gì;
- dữ liệu đi qua đâu;
- API nào gọi API nào;
- bảng database nào liên quan;
- phần nào tuyệt đối không được sửa;
- lỗi nào từng xảy ra;
- lý do tại sao một đoạn code trông “kỳ quặc” nhưng thực ra lại cần thiết.
Mỗi lần bạn mở một cuộc hội thoại mới, một agent mới, thậm chí một context mới, AI có thể không biết những quyết định trước đó.
Nếu không có tài liệu, AI phải suy luận lại hệ thống từ code.
Và đây chính là nguồn gốc của rất nhiều tai nạn trong vibe coding.
AI thấy một đoạn code có vẻ thừa:
Nó xóa.“Đoạn này có thể simplify.”
Ba tiếng sau WebSocket reconnect bị lỗi.
AI thấy database có hai trường gần giống nhau:
Nó refactor.“Có thể hợp nhất.”
Ngày hôm sau một cron job cũ bắt đầu ghi sai dữ liệu.
AI thấy authentication middleware phức tạp:
Và vô tình phá một trường hợp edge case đã được xử lý từ sáu tháng trước.“Có thể viết lại gọn hơn.”
Vấn đề ở đây không phải AI kém.
Vấn đề là AI thiếu lịch sử và thiếu ngữ cảnh.
2. Vì vậy một dự án AI nên có “bộ nhớ ngoài”
Có thể coi hệ thống tài liệu của dự án như long-term memory của AI.Một dự án nghiêm túc nên có ít nhất một số loại tài liệu sau.
PRD – Product Requirements Document
PRD trả lời:Sản phẩm này phải làm gì?
Ví dụ:
- người dùng là ai;
- tính năng chính;
- use case;
- business rule;
- phạm vi tính năng;
- các điều kiện đặc biệt.
SRS – Software Requirements Specification
SRS đi sâu hơn vào yêu cầu kỹ thuật.Ví dụ:
- functional requirements;
- non-functional requirements;
- authentication;
- performance;
- concurrency;
- security;
- scalability;
- reliability.
SRS có thể nói:Người chơi có thể reconnect vào trận đấu.
Hai thứ rất khác nhau.Khi mất kết nối dưới 30 giây, người chơi được phép reconnect và server phải gửi lại authoritative game state.
SPD / Technical Design / System Design Document
Tên gọi ở mỗi đội có thể khác nhau: SPD, Software Design Specification, Technical Design Document hay System Design Document.Nội dung thường mô tả:
- kiến trúc hệ thống;
- database schema;
- module;
- service;
- API;
- event;
- queue;
- cache;
- authentication flow;
- deployment;
- data flow;
- các quyết định kỹ thuật quan trọng.
Client
↓
Next.js
↓
NestJS API
↓
PostgreSQL
↓
Redis
Realtime:
Client
↓
Socket.IO
↓
Game Server
↓
Redis Presence
Một sơ đồ vài dòng như vậy đôi khi giúp AI hiểu hệ thống tốt hơn hàng nghìn dòng source code.
3. SOP – thứ đặc biệt quan trọng khi làm việc với AI
SOP – Standard Operating Procedure – có thể hiểu đơn giản là:“Khi X xảy ra thì chúng ta phải làm gì?”
Ví dụ SOP deploy:
1. Chạy test
2. Chạy lint
3. Build production
4. Kiểm tra migration
5. Backup database
6. Deploy staging
7. Smoke test
8. Deploy production
9. Theo dõi error monitoring 15 phút
10. Nếu error rate tăng → rollback
Hoặc SOP xử lý lỗi production:
1. Xác định thời điểm lỗi
2. Kiểm tra Sentry
3. Kiểm tra logs
4. Kiểm tra trace ID
5. Kiểm tra release vừa deploy
6. Reproduce lỗi
7. Viết test tái hiện lỗi
8. Fix
9. Review diff
10. Deploy staging
11. Verify
12. Production rollout
Khi làm với AI, SOP đặc biệt hữu ích.
Thay vì nói:
hãy để AI làm theo một quy trình:“Fix lỗi này đi.”
Chỉ một thay đổi nhỏ trong cách giao việc như vậy có thể làm chất lượng AI coding khác hoàn toàn.“Thực hiện Incident Debugging SOP. Trước tiên xác định nguyên nhân, không sửa code cho đến khi tìm thấy evidence.”
4. Một nguyên tắc rất quan trọng: AI không nên sửa lỗi chỉ dựa trên mô tả của người dùng
Một người báo:Thông tin đó gần như chưa đủ.“Bấm nút thanh toán không được.”
Bạn cần biết:
- browser nào;
- thiết bị nào;
- user nào;
- URL nào;
- request nào;
- response nào;
- HTTP status;
- stack trace;
- console error;
- server log;
- database query;
- release version;
- user đã làm gì trước đó.
có thể được biến thành:“Tại sao người dùng này thanh toán thất bại?”
User
↓
Session Replay
↓
POST /api/payment
↓
trace_id: abc123
↓
PaymentService
↓
Redis timeout
↓
retry
↓
provider returned 409
Đây mới là dữ liệu AI cần.
5. Logging không đủ – cần Observability
Nhiều dự án chỉ có:console.log("something happened")
hoặc:
console.error(error)
Đó chưa phải observability.
Một hệ thống hiện đại thường quan sát ít nhất ba loại tín hiệu:
Logs
Cho biết:Chuyện gì đã xảy ra?
Ví dụ:
{
"level": "error",
"service": "payment-api",
"user_id": 9831,
"order_id": 15733,
"error": "PAYMENT_TIMEOUT",
"trace_id": "abc123"
}
Metrics
Cho biết:Hệ thống đang hoạt động như thế nào?
Ví dụ:
requests/sec
error rate
CPU
RAM
DB connections
Redis latency
queue size
p95 response time
Traces
Cho biết:Một request đã đi qua hệ thống như thế nào?
Ví dụ:
Browser
↓ 40ms
API Gateway
↓ 25ms
Auth Service
↓ 15ms
Order Service
↓ 430ms
Database
OpenTelemetry hiện là một framework observability mã nguồn mở, vendor-neutral để instrument và thu thập các tín hiệu như traces, metrics và logs, đồng thời có thể xuất dữ liệu tới nhiều backend khác nhau.
Đây là một công nghệ rất đáng tìm hiểu nếu muốn xây hệ thống lâu dài thay vì khóa chặt mình vào một nhà cung cấp.
6. Error Tracking: thứ một ứng dụng production gần như nên có mặc định
Một lỗi JavaScript xảy ra trên máy người dùng có thể không bao giờ xuất hiện trên máy developer.Ví dụ:
TypeError:
Cannot read properties of undefined
Nếu không có error tracking, developer chỉ nhận được báo cáo:
Và bắt đầu đoán.“Trang bị trắng.”
Đây là lý do các công cụ như Sentry trở nên hữu ích.
Một error-monitoring platform có thể liên kết:
- exception;
- stack trace;
- release;
- environment;
- browser;
- user;
- breadcrumbs;
- transaction;
- trace;
- session replay.
Điều thú vị hơn trong thời đại AI là dữ liệu lỗi cũng ngày càng được thiết kế để AI đọc trực tiếp. Ví dụ Sentry hiện hỗ trợ trả event theo định dạng dành cho LLM như JSON, Markdown hoặc XML.
Nghĩa là workflow có thể dần chuyển từ:
User báo lỗi
→ Developer đọc
→ Developer tìm code
→ Developer sửa
sang:
Error system phát hiện lỗi
↓
thu thập stack trace + context
↓
AI đọc incident
↓
AI tìm commit liên quan
↓
AI phân tích nguyên nhân
↓
AI đề xuất patch
↓
Human review
↓
test
↓
deploy
Đây mới là một hình thức AI-assisted software engineering thực sự mạnh.
7. Session Replay: đôi khi giá trị hơn hàng nghìn dòng log
Có những lỗi không crash.Ví dụ:
- người dùng bấm nút nhưng không phản hồi;
- form reset bất ngờ;
- dropdown bị che;
- mobile layout lỗi;
- checkout loop;
- user bị đưa về trang trước;
- JavaScript chạy nhưng UI state sai.
Session Replay giải quyết một phần bài toán này.
PostHog mô tả Session Replay như việc ghi lại cách người dùng thực sự tương tác với sản phẩm, đồng bộ cùng console logs, network request và errors tại đúng thời điểm xảy ra.
Khi đó thay vì hỏi:
developer hoặc AI có thể xem lại chính session đó.“Bạn đã bấm nút nào trước khi lỗi?”
8. Một công cụ rất đáng chú ý: PostHog
PostHog ban đầu được nhiều người biết đến như product analytics nhưng hiện đã mở rộng khá xa.Hệ thống hiện có các thành phần như:
- Product Analytics
- Web Analytics
- Session Replay
- Feature Flags
- Experiments
- Error Tracking
- Logs
- Tracing
- AI Observability
- Surveys
Một điểm đặc biệt thú vị với vibe coding là PostHog còn hỗ trợ workflow AI/MCP để AI agent đọc dữ liệu debugging.
Điều này tạo ra một vòng lặp rất đáng chú ý:
User behavior
↓
Analytics
↓
Error
↓
Session Replay
↓
Stack trace
↓
AI
↓
Code
9. Nếu ứng dụng của bạn có AI/LLM thì còn cần AI Observability
Một ứng dụng dùng LLM có thêm một loại lỗi khác.Không crash.
Không HTTP 500.
Nhưng AI trả lời sai.
Ví dụ:
Prompt A
→ model
→ tool call
→ database
→ model
→ answer
Bạn cần biết:
- prompt nào;
- model nào;
- token bao nhiêu;
- latency;
- cost;
- tool nào được gọi;
- tool trả gì;
- response cuối cùng;
- evaluation score.
Các dự án xây AI agent, chatbot hay workflow tự động nên coi loại telemetry này quan trọng tương tự application logs.
10. Uptime monitoring: đừng để khách hàng trở thành hệ thống cảnh báo
Một trong những tình huống tệ nhất là:Sau đó khách hàng nhắn:Server chết 40 phút nhưng developer không biết.
Đây là lý do cần uptime monitoring.“Website anh bị lỗi à?”
Một monitor bên ngoài có thể định kỳ gọi:
Nếu website không trả về HTTP thành công, hệ thống tự động tạo incident và cảnh báo.
Better Stack chẳng hạn hỗ trợ monitoring endpoint từ bên ngoài, tạo incident khi service lỗi, đồng thời có hệ thống logs, tracing, on-call và status page.
Một production stack tốt không nên dựa vào:
Máy móc nên làm việc đó 24/7.“Thỉnh thoảng tôi mở website xem còn chạy không.”
11. Các công cụ đáng cân nhắc
Không nhất thiết phải dùng tất cả.Sentry
Rất phù hợp cho:- application errors;
- exception tracking;
- stack trace;
- release tracking;
- performance;
- tracing;
- session replay.
PostHog
Rất mạnh nếu muốn kết hợp:Analytics
+
Session Replay
+
Error Tracking
+
Feature Flags
+
Experiments
+
AI Observability
Đặc biệt hợp với startup và sản phẩm web cần hiểu hành vi người dùng.
OpenTelemetry
Phù hợp nếu muốn xây nền tảng observability bài bản và tránh phụ thuộc một vendor.Kiến trúc có thể là:
Application
↓
OpenTelemetry SDK
↓
OTel Collector
↓
Sentry / Grafana / Datadog / backend khác
Grafana ecosystem
Một stack self-host phổ biến có thể gồm:Prometheus → Metrics
Loki → Logs
Tempo → Traces
Grafana → Dashboard
Rất phù hợp nếu có server riêng và muốn kiểm soát hệ thống monitoring.
Better Stack
Có thể gom khá nhiều thứ:Uptime
Logs
Incident
On-call
Status Page
Tracing
Logs có thể được tập trung từ nhiều nguồn và query từ một nơi thay vì SSH từng server để tìm file log.
Datadog
Ở hệ thống lớn hơn, Datadog là một nền tảng observability mạnh, đặc biệt khi cần theo dõi:Infrastructure
APM
Logs
RUM
Database
Containers
Cloud
Security
Đổi lại chi phí và độ phức tạp thường cao hơn các giải pháp đơn giản cho dự án nhỏ.
12. Một stack thực tế cho dự án vibe coding nhỏ
Không cần biến một website 1.000 user thành hệ thống NASA.Có thể bắt đầu rất đơn giản.
Level 1 – dự án nhỏ
GitHub+
Sentry
+
Uptime Monitor
Đã tốt hơn rất nhiều dự án production ngoài kia.
Level 2 – startup / web app
GitHubSentry
PostHog
Better Stack
Trong đó:
Sentry
→ lỗi code
PostHog
→ user behavior + replay
Better Stack
→ uptime + infrastructure/log
GitHub
→ source + release
Level 3 – hệ thống lớn hơn
OpenTelemetry↓
OTel Collector
↓
┌──────────┬──────────┬──────────┐
Logs Metrics Traces
↓ ↓ ↓
Loki Prometheus Tempo
↓
Grafana
Sau đó có thể kết hợp thêm Sentry cho application errors.
13. Quan trọng hơn công cụ: phải có ID xuyên suốt hệ thống
Một kỹ thuật cực kỳ hữu ích là Correlation ID / Trace ID.Ví dụ user thực hiện:
POST /api/orders
Server tạo:
trace_id = 7f83ab2
Sau đó mọi service đều ghi:
Frontend
trace_id=7f83ab2
API
trace_id=7f83ab2
Redis
trace_id=7f83ab2
Payment
trace_id=7f83ab2
Database
trace_id=7f83ab2
Khi có lỗi, chỉ cần tìm:
7f83ab2
là có thể dựng lại gần như toàn bộ câu chuyện.
Với hệ thống distributed, đây là một trong những kỹ thuật đáng giá nhất.
14. Nhưng tuyệt đối đừng log mọi thứ
Logging cũng có mặt nguy hiểm.Không nên vô tư log:
password
access token
refresh token
credit card
cookie
authorization header
private message
personal information
Observability phải đi cùng:
- masking;
- redaction;
- access control;
- retention policy;
- sampling;
- data minimization.
Một hệ thống debug tuyệt vời nhưng vô tình trở thành kho chứa password thì không còn tuyệt vời nữa.
15. Error tracking chỉ có giá trị khi gắn với release
Một lỗi:TypeError at user.service.ts:127
chưa đủ.
Điều thực sự hữu ích là:
Error started:
release 2.7.41
commit 8ac271d
first seen:
09:42
deployment:
09:38
Khi đó giả thuyết đầu tiên gần như hiện ra ngay:
09:38 deploy
↓
09:42 error xuất hiện
AI cũng có thể so sánh:
commit trước
vs
commit sau
và khoanh vùng thay đổi.
Vì vậy CI/CD nên gửi thông tin release cho hệ thống monitoring.
16. Và đây là nơi Git trở thành một phần của observability
Git không chỉ để backup code.Một repository tốt phải cho bạn trả lời:
Ai thay đổi?
Thay đổi gì?
Khi nào?
Tại sao?
Release nào chứa thay đổi đó?
Một commit kiểu:
update
gần như vô nghĩa.
Một commit:
fix(game): prevent duplicate move after websocket reconnect
thì cả developer lẫn AI đều hiểu được.
Trong thời đại AI, Git history cũng chính là một dạng memory.
17. AI nên đọc cả code lẫn “operational context”
Một AI coding agent lý tưởng không chỉ được cấp:/src
mà còn nên được tiếp cận:
/docs
/architecture
/SOP
/ADR
/runbooks
/tests
/logs
/issues
/releases
Nếu có MCP hoặc API phù hợp, AI còn có thể truy vấn:
GitHub
Sentry
PostHog
Grafana
Database
CI/CD
Khi đó AI không còn là một “code generator”.
Nó bắt đầu hoạt động giống một junior/mid-level software engineer có khả năng quan sát hệ thống.
18. ADR – một tài liệu nhỏ nhưng cực kỳ hữu ích với AI
ADR là Architecture Decision Record.Ví dụ:
ADR-014
Decision:
Use Redis for realtime presence.
Reason:
Presence data is ephemeral.
Database writes would be unnecessary.
TTL:
40 seconds.
Heartbeat:
10 seconds.
Do not migrate presence state to PostgreSQL.
Sáu tháng sau AI nhìn code và hỏi:
ADR đã trả lời.“Tại sao không lưu presence vào PostgreSQL cho đơn giản?”
Nếu không có ADR, AI rất dễ “cải tiến” một quyết định mà team đã mất ba ngày tranh luận mới đưa ra.
19. Runbook – khi hệ thống cháy thì đừng bắt đầu suy nghĩ từ số 0
Ví dụ:RUNBOOK: DATABASE CPU > 90%
1. Check active connections
2. Check slow queries
3. Check recent deployments
4. Check missing indexes
5. Check background jobs
6. Do NOT restart database immediately
7. Capture diagnostics
8. Escalate if >15 minutes
Runbook đặc biệt hữu ích khi kết hợp AI.
AI có thể được giao:
Thay vì:Follow database-high-CPU runbook and report findings.
Hai prompt này tạo ra hai chất lượng xử lý sự cố hoàn toàn khác nhau.Server chậm quá, xem giúp tôi.
20. Một workflow rất mạnh trong thời đại AI
Tưởng tượng production phát sinh lỗi.USER
↓
APPLICATION
↓
SENTRY detects exception
↓
TRACE ID
↓
LOG SYSTEM
↓
SESSION REPLAY
↓
GITHUB RELEASE
↓
AI AGENT
AI nhận được:
Exception
Stack trace
Logs
Session
Trace
Commit
Diff
SOP
Architecture docs
Sau đó AI:
1. phân tích nguyên nhân
2. tìm commit khả nghi
3. reproduce
4. viết regression test
5. tạo patch
6. chạy test
7. trình diff cho developer
Developer quyết định merge hay không.
Đó là một hình thức vibe coding rất khác với:
“Claude, sửa code này giúp tôi.”
21. Đừng để AI trở thành một lập trình viên mất trí nhớ
AI có thể cực kỳ giỏi.Nhưng nếu mỗi ngày bạn giao cho nó một codebase mà không có:
Documentation
Architecture
SOP
Logs
Tests
History
Observability
thì gần giống như mỗi sáng bạn thuê một developer thiên tài mới.
Developer đó:
- code rất nhanh;
- biết rất nhiều công nghệ;
không nhớ hôm qua team đã quyết định gì.
Đến chiều developer đó nghỉ.
Sáng hôm sau một developer thiên tài khác xuất hiện.
Đó chính là một trong những vấn đề cốt lõi của AI coding.
22. Tài liệu và observability chính là cách giải quyết vấn đề đó
Một hệ thống phần mềm trưởng thành dần sẽ hình thành ba lớp “trí nhớ”.Memory của sản phẩm
PRDSRS
business rules
Memory của kiến trúc
System DesignADR
API docs
Database schema
Memory của vận hành
SOPRunbook
Logs
Metrics
Traces
Incidents
Postmortem
AI càng có nhiều dữ liệu đúng từ ba lớp này, khả năng làm việc chính xác càng cao.
23. Và cuối cùng: Observability không phải chỉ để sửa lỗi
Một hệ thống observability tốt còn trả lời:Tính năng nào chậm?
API nào lỗi nhiều?
Browser nào hay crash?
Release nào gây regression?
Query nào đang chậm?
Người dùng bỏ cuộc ở bước nào?
Server nào quá tải?
Feature nào ít người dùng?
Một lỗi ảnh hưởng 2 người hay 20.000 người?
PostHog chẳng hạn có thể kết hợp exception với product analytics để phân tích trend, funnel hay retention, và Error Tracking dashboard có thể hiển thị số lần xuất hiện cũng như số user bị ảnh hưởng.
Đó là sự khác biệt giữa:
và:“Có lỗi.”
Câu thứ hai mới là thông tin để ra quyết định.“Lỗi này xuất hiện 1.842 lần, ảnh hưởng 317 người dùng, bắt đầu sau release 2.4.7 và chủ yếu xảy ra trên Safari khi thực hiện checkout.”
Kết luận
Vibe coding giúp chúng ta tạo phần mềm với tốc độ chưa từng có.Nhưng tốc độ viết code càng tăng thì một vấn đề khác càng trở nên quan trọng:
khả năng hiểu, kiểm soát và quan sát hệ thống.
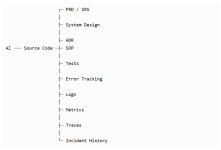
Một dự án nghiêm túc không nên chỉ có:
AI + Source Code
Mà nên dần tiến tới:
┌─ PRD / SRS
│
├─ System Design
│
├─ ADR
AI ─── Source Code ─┼─ SOP
│
├─ Tests
│
├─ Error Tracking
│
├─ Logs
│
├─ Metrics
│
├─ Traces
│
└─ Incident History
Khi đó AI không còn phải đoán hệ thống của bạn hoạt động như thế nào.
Nó có bằng chứng để hiểu.
Và có lẽ đây mới là bước tiến tiếp theo của vibe coding:
Không phải làm cho AI viết nhiều code hơn.
Mà là xây dựng một môi trường để AI hiểu hệ thống tốt hơn, phát hiện vấn đề chính xác hơn và thay đổi code một cách có kiểm soát hơn.
Một sản phẩm tốt không phải là sản phẩm không bao giờ có lỗi.
Mà là sản phẩm mà khi lỗi xảy ra, chúng ta biết:
lỗi ở đâu, vì sao xảy ra, ảnh hưởng tới ai, xuất hiện từ khi nào, thay đổi nào gây ra nó và làm thế nào để nó không quay trở lại.